


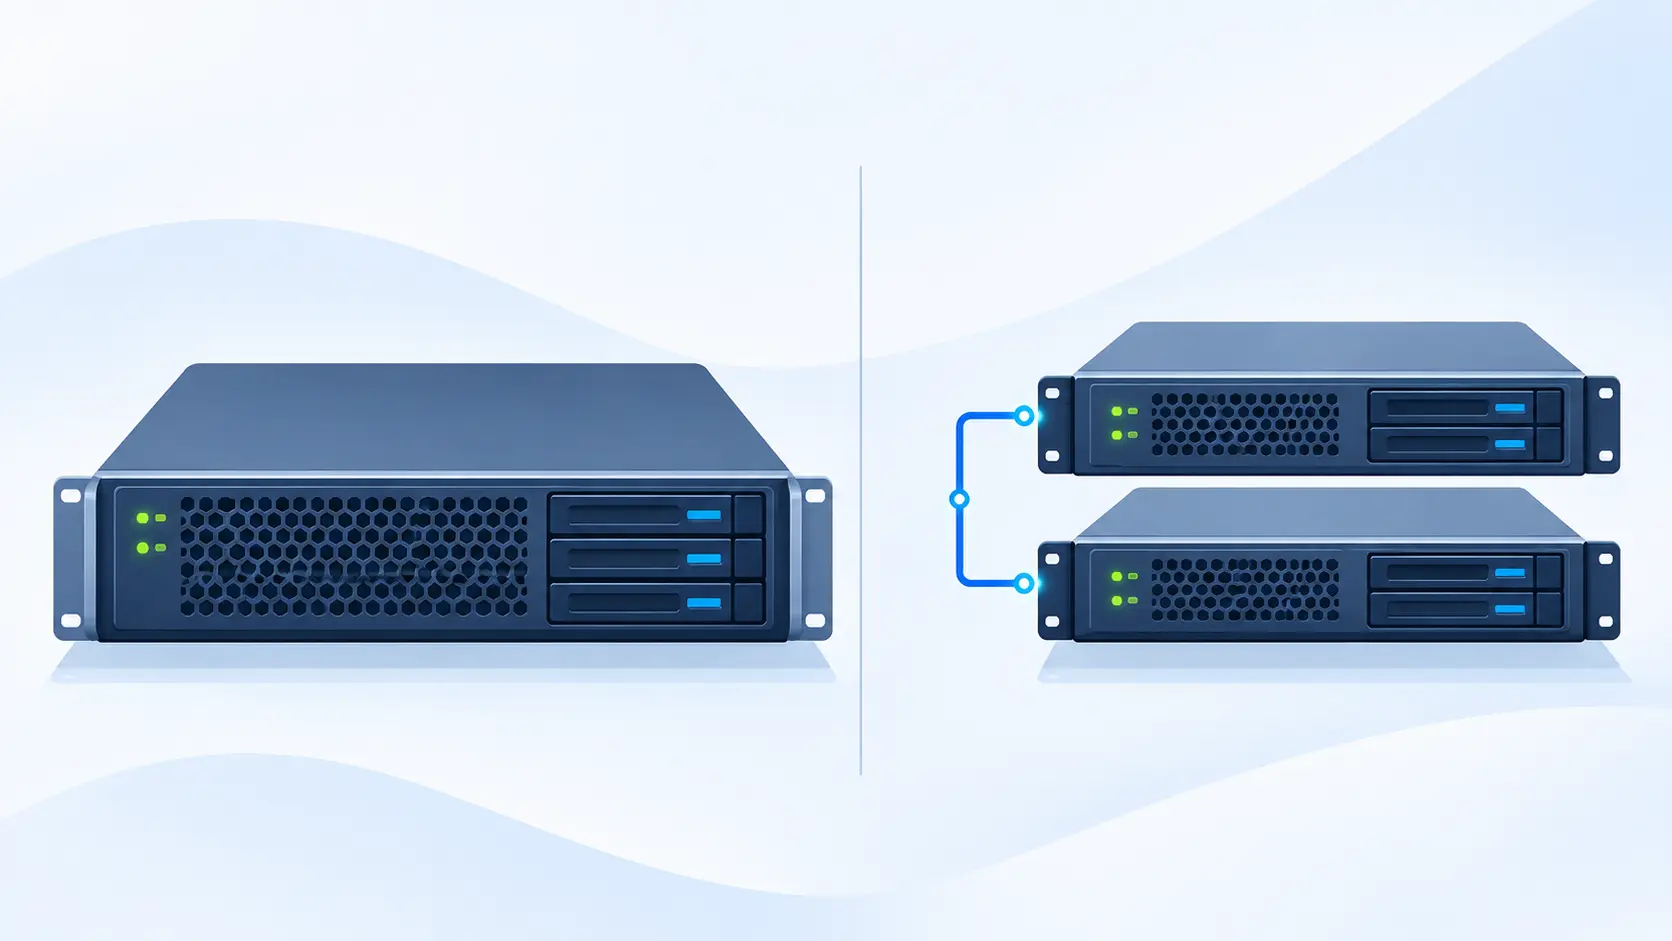
При обновлении серверной инфраструктуры организация часто сталкивается с выбором: приобрести один производительный сервер с большим запасом ресурсов или распределить нагрузку между двумя менее мощными устройствами. На первый взгляд первый вариант выглядит экономичнее, поскольку требует меньше оборудования, лицензий на отдельные компоненты и места в стойке. Второй привлекает возможностью распределения виртуальных машин и потенциального резервирования.
Однако количество физических серверов само по себе не определяет надёжность инфраструктуры. Два независимых хоста могут уменьшить последствия отдельных аппаратных неисправностей, но не гарантируют автоматического восстановления виртуальных машин. Для высокой доступности необходимы подходящая платформа виртуализации, доступность данных, механизмы кластеризации и достаточный резерв вычислительных ресурсов.
Разберём, когда выгоднее один мощный сервер, а когда стоит выбрать два небольших. Сравним производительность, возможности виртуализации, сценарии отказа, требования к хранению данных и сети, стоимость лицензирования и перспективы расширения. На расчётном примере покажем, почему два сервера с достаточной суммарной производительностью не всегда способны обеспечить работу после отказа одного узла.
Содержание
- От чего зависит выбор серверной архитектуры
- Один сервер или два: основные отличия
- Когда выгоднее один мощный сервер
- Преимущества и ограничения двух серверов
- Как рассчитать ресурсы для виртуализации
- Пример расчёта для 12 виртуальных машин
- Отказоустойчивость: почему два сервера не равны кластеру
- Как организовать хранение данных
- Какая сетевая инфраструктура необходима
- Как лицензирование влияет на стоимость
- Сравнение совокупной стоимости владения
- Как предусмотреть дальнейший рост
- Практические сценарии выбора
- Пошаговый алгоритм принятия решения
- Типичные ошибки проектирования
- Итог
- Часто задаваемые вопросы
От чего зависит выбор серверной архитектуры
При сравнении архитектур необходимо учитывать не только производительность процессоров и объём оперативной памяти.
Не менее важны требования к доступности приложений, время допустимого простоя, характер дисковой нагрузки и условия дальнейшего масштабирования.
Какие вопросы необходимо решить перед закупкой
- Сколько виртуальных машин будет работать одновременно?
- Какие приложения требуют постоянной доступности?
- Какой объём процессорных ресурсов и памяти необходим?
- Какую нагрузку создают базы данных и файловые системы?
- Допускает ли организация остановку сервисов на время обслуживания?
- Сколько времени допустимо потратить на восстановление после аварии?
- Планируется ли увеличение количества виртуальных машин?
- Какой бюджет предусмотрен на оборудование, лицензии и эксплуатацию?
Почему одинаковая суммарная производительность не означает одинаковые возможности
Предположим, организация рассматривает один сервер с 256 ГБ оперативной памяти или два сервера по 128 ГБ.
На первый взгляд оба варианта предоставляют одинаковый суммарный объём памяти.
Но в случае отказа одного из двух узлов доступными останутся только 128 ГБ, тогда как при отказе единственного сервера вычислительные ресурсы полностью перестанут быть доступны.
Если для непрерывной работы всех виртуальных машин необходимо 180 ГБ памяти, оставшийся небольшой сервер не сможет разместить полную нагрузку без изменения конфигурации.
Один сервер или два: основные отличия
Обе архитектуры способны успешно обслуживать корпоративные приложения, но имеют разные эксплуатационные характеристики.
| Критерий | Один мощный сервер | Два небольших сервера |
|---|---|---|
| Начальная архитектура | Проще | Требует организации взаимодействия узлов |
| Распределение нагрузки | Между виртуальными машинами одного хоста | Между двумя физическими хостами |
| Аппаратный отказ | Затрагивает все размещённые виртуальные машины | Может затронуть только часть нагрузки |
| Автоматическое восстановление | Требует внешней резервной инфраструктуры | Возможно при соответствующей кластерной архитектуре |
| Обслуживание | Может потребовать остановки сервисов | Возможен перенос нагрузки при поддержке платформы |
| Оперативная память | Доступна в пределах одного хоста | Разделена между физическими узлами |
| Сетевые подключения | Обычно меньше | Больше интерфейсов и соединений |
| Администрирование | Относительно простое | Сложнее при кластеризации и репликации |
| Расширение | Замена или добавление ресурсов одного сервера | Модернизация узлов либо добавление новых при поддержке платформы |
Ни один вариант нельзя считать универсально лучшим. При небольшом количестве виртуальных машин единый сервер может обеспечить оптимальное соотношение стоимости и производительности.
Для критичных приложений возможность пережить аппаратный отказ без длительного простоя может оказаться важнее экономии на первоначальной закупке.
Когда выгоднее один мощный сервер
Один производительный сервер подходит организациям, которым необходима централизованная вычислительная платформа без сложной кластерной инфраструктуры.
Небольшое количество виртуальных машин
Если компания использует несколько виртуальных серверов для бухгалтерии, файлового обмена, внутреннего веб-приложения и системы управления, одна современная платформа может обеспечить достаточную производительность с запасом.
При этом важно правильно рассчитать процессорные ресурсы, оперативную память и дисковую подсистему.
Меньше компонентов для обслуживания
Один сервер обычно требует меньшего количества отдельных сетевых подключений, системных обновлений и операций администрирования.
Это особенно удобно для компаний без выделенной команды серверных инженеров.
Высокая производительность одной виртуальной машины
Некоторые приложения требуют большого объёма оперативной памяти или значительных вычислительных ресурсов в рамках одной виртуальной машины.
Один мощный сервер может оказаться предпочтительнее двух небольших, если требуемая виртуальная машина физически не помещается на отдельном меньшем узле.
Ограничения односерверной архитектуры
Главный недостаток — зависимость всех размещённых сервисов от одного физического хоста.
Даже при наличии резервных блоков питания, RAID-массива и других отказоустойчивых компонентов остаются риски неисправности системной платы, процессорной платформы или других общих элементов.
Плановые обновления гипервизора также могут потребовать остановки или переноса виртуальных машин на внешнюю площадку.
Если организация планирует купить сервер для виртуализации, необходимо сравнивать модели по поддерживаемому объёму памяти, количеству процессорных ядер, дисковой конфигурации, возможностям расширения и совместимости с выбранным гипервизором. Избыточные характеристики не всегда оправданы, если приложения не способны использовать предоставленные ресурсы.
Преимущества и ограничения двух серверов
Два физических сервера позволяют распределять виртуальные машины между независимыми вычислительными узлами.
Но преимущества такой архитектуры зависят от организации хранения, сети и программного управления.
Разделение рабочих нагрузок
Например, на первом сервере можно разместить базу данных и корпоративное приложение, а на втором — файловые службы и инфраструктурные сервисы.
Такое распределение уменьшает концентрацию нагрузки на одном физическом устройстве.
Независимое обслуживание
При наличии соответствующей платформы и достаточных ресурсов виртуальные машины можно переносить между узлами перед обслуживанием оборудования.
Но простое наличие двух серверов не обеспечивает такую возможность автоматически.
Снижение последствий аппаратной неисправности
Если два независимых сервера работают без кластеризации, отказ одного из них затронет размещённые на нём приложения, но не обязательно остановит сервисы второго.
Это уменьшает масштаб отдельного сбоя, однако не гарантирует доступность всех сервисов.
Дополнительные затраты
Два сервера обычно требуют большего количества физических компонентов, соединений и операций сопровождения.
В зависимости от выбранной платформы могут понадобиться дополнительные лицензии, система хранения и сетевое оборудование.
Как рассчитать ресурсы для виртуализации
При выборе конфигурации необходимо учитывать реальные потребности виртуальных машин, а не только количество запланированных экземпляров.
Две виртуальные машины могут иметь одинаковое число виртуальных процессоров, но создавать совершенно разную нагрузку.
Расчёт процессорных ресурсов
Количество виртуальных процессоров vCPU не всегда равно количеству физических ядер.
Современные гипервизоры могут распределять процессорное время между виртуальными машинами, используя механизмы планирования и допустимого превышения выделенных виртуальных ресурсов над физическими.
Но слишком большое превышение при высокой одновременной нагрузке приводит к конкуренции за вычислительные ресурсы и увеличению задержек.
Поэтому необходимо учитывать:
- среднюю и пиковую загрузку процессора;
- одновременную активность виртуальных машин;
- требования приложений к задержкам;
- количество физических ядер;
- особенности NUMA-архитектуры;
- резерв для обслуживания и отказа узла.
Расчёт оперативной памяти
Оперативная память часто представляет собой один из главных ограничителей плотности виртуализации.
При предварительном расчёте необходимо учитывать память виртуальных машин, ресурсы гипервизора и дополнительный резерв.
RAMтреб = RAMвиртуальных машин + RAMгипервизора + резерв.
Если платформа поддерживает технологии динамического управления памятью, их влияние необходимо оценивать отдельно. Нельзя рассчитывать критичную инфраструктуру исключительно на предположении, что все виртуальные машины никогда не используют выделенную память одновременно.
Дисковая производительность
При расчёте хранения важно учитывать не только необходимую ёмкость.
Для баз данных, виртуальных рабочих столов и корпоративных приложений существенное значение имеют IOPS, задержки и характер операций чтения и записи.
Если дисковая система не обеспечивает требуемую производительность, добавление процессоров или оперативной памяти может не решить проблему.
Резерв на рост
Для прогнозируемого увеличения количества виртуальных машин необходимо предусмотреть возможность расширения памяти, вычислительных ресурсов, хранилища и сетевых интерфейсов.
Конкретный резерв зависит от планов развития организации, а не от универсального процентного норматива.
Пример расчёта для 12 виртуальных машин
Рассмотрим условную организацию, которая планирует разместить 12 виртуальных машин с корпоративными приложениями.
В качестве исходных данных примем следующие значения:
| Группа виртуальных машин | Количество | Память одной ВМ | Суммарная память |
|---|---|---|---|
| Инфраструктурные сервисы | 4 | 8 ГБ | 32 ГБ |
| Корпоративные приложения | 4 | 16 ГБ | 64 ГБ |
| Базы данных и специализированные приложения | 4 | 24 ГБ | 96 ГБ |
| Итого | 12 | — | 192 ГБ |
Все значения условные и предназначены для демонстрации методики выбора.
Вариант 1. Один сервер с 256 ГБ памяти
Общий объём оперативной памяти составляет 256 ГБ.
Если виртуальным машинам выделено 192 ГБ, остаётся:
256 − 192 = 64 ГБ.
Этот объём должен покрывать потребности гипервизора и предусмотренный проектом резерв.
По памяти конфигурация может соответствовать поставленной задаче, но окончательное решение требует проверки процессорной и дисковой нагрузки.
Вариант 2. Два сервера по 128 ГБ
Общий установленный объём памяти также равен 256 ГБ.
При нормальной работе виртуальные машины можно распределить между двумя узлами.
Например, на каждом разместить нагрузку с выделением 96 ГБ памяти, оставив 32 ГБ под гипервизор и резерв.
Однако при отказе одного узла второй физически содержит только 128 ГБ.
192 ГБ необходимой памяти виртуальных машин больше 128 ГБ доступной физической памяти одного сервера.
Следовательно, второй вариант не сможет разместить всю исходную нагрузку на оставшемся узле без снижения потребления, остановки части сервисов или использования иных специально спроектированных механизмов.
Вариант 3. Два сервера по 256 ГБ
Если каждый узел имеет 256 ГБ памяти, то с точки зрения её установленного объёма любой из серверов потенциально способен разместить все 12 виртуальных машин.
Но для реальной отказоустойчивости дополнительно необходимы:
- достаточное количество вычислительных ресурсов на каждом узле;
- доступность данных виртуальных машин;
- корректная конфигурация гипервизора и кластера;
- надёжное сетевое подключение;
- подходящая схема кворума;
- проверенные процедуры восстановления.
Сравнение вариантов
| Конфигурация | Суммарная RAM | Может ли один оставшийся узел разместить 192 ГБ ВМ? |
|---|---|---|
| 1 × 256 ГБ | 256 ГБ | Нет второго узла |
| 2 × 128 ГБ | 256 ГБ | Нет, по физическому объёму памяти |
| 2 × 256 ГБ | 512 ГБ | Потенциально да, после проверки остальных требований |
Отказоустойчивость: почему два сервера не равны кластеру
Отказоустойчивость серверной инфраструктуры предполагает возможность сохранить или восстановить доступность сервисов при определённых неисправностях.
Для этого необходимо учитывать не только физические серверы, но и программные механизмы управления виртуальными машинами.
Что такое кластер высокой доступности
В кластерной архитектуре несколько серверов объединяют в управляемую систему, способную контролировать состояние узлов и выполнять предусмотренные действия при неисправности.
При отказе одного сервера соответствующая платформа может запускать его виртуальные машины на доступных узлах.
Но возможность и порядок восстановления зависят от гипервизора, конфигурации хранения, сетевых соединений и наличия свободных ресурсов.
Почему нужен кворум
В распределённых системах возможна ситуация, когда узлы теряют связь друг с другом, но продолжают работать.
Если обе стороны одновременно считают себя основными, возникает риск конфликтующих операций и повреждения данных.
Механизм кворума помогает определить, какая часть кластера имеет право продолжать работу.
Особенности двухузлового кластера
Для двухузловых кластеров нередко используют дополнительный элемент голосования — witness, или свидетель кворума.
В зависимости от программной платформы им может выступать файловый ресурс, облачная служба или специальный диск.
Конкретная конфигурация определяется требованиями используемого кластерного решения.
Высокая доступность не означает отсутствие перерыва
Если физический хост внезапно отключается, виртуальным машинам может потребоваться повторный запуск на другом узле.
Это сопровождается определённым временем восстановления.
Поэтому необходимо различать:
- Высокую доступность. Автоматическое восстановление сервисов после определённых отказов.
- Живую миграцию. Перенос работающей виртуальной машины при поддержке платформы и выполнении необходимых условий.
- Репликацию. Создание и поддержание копии данных или виртуальной машины на другом узле.
- Резервное копирование. Сохранение данных для последующего восстановления.
- Непрерывную работу без перерыва. Более строгую задачу, требующую специальных механизмов и архитектуры.
Как организовать хранение данных
При выборе серверной архитектуры система хранения часто оказывает не меньшее влияние на итоговую стоимость, чем вычислительные узлы.
Виртуальные машины используют дисковые образы, конфигурационные файлы и данные приложений. Для восстановления нагрузки на другом сервере эти данные должны оставаться доступными согласованным способом.
Локальные диски одного сервера
Простейшая конфигурация предусматривает размещение виртуальных машин на накопителях непосредственно внутри физического сервера.
Такое решение может обеспечивать хорошую производительность при относительно простой архитектуре.
Но при выходе всего сервера из строя доступ к данным может оказаться невозможным до восстановления оборудования либо запуска копий на другой платформе.
Общая система хранения
При использовании внешней СХД несколько серверов могут получать доступ к поддерживаемым общим ресурсам хранения.
Это позволяет реализовывать определённые сценарии кластеризации и миграции виртуальных машин.
Но общая СХД сама способна стать точкой отказа, если её контроллеры, диски, питание и каналы подключения не имеют необходимого резервирования.
Программно-определяемое хранение
Другой вариант — использовать программные решения, которые объединяют локальные накопители нескольких серверов в распределённую систему хранения.
Такая архитектура может уменьшить зависимость от отдельной внешней СХД, но предъявляет требования к сети, дискам, ресурсам серверов, числу узлов и схеме обеспечения согласованности данных.
Наличие двух узлов не гарантирует, что любое программно-определяемое хранилище сможет работать после отказа одного из них. Необходимо проверять поддерживаемые конфигурации конкретной платформы.
Что учитывать при выборе СХД
| Параметр | Значение для виртуализации |
|---|---|
| Полезная ёмкость | Размещение дисков виртуальных машин и данных |
| IOPS | Обработка большого количества дисковых операций |
| Задержки | Скорость отклика баз данных и приложений |
| Отказоустойчивость | Сохранение доступности при предусмотренных отказах |
| Сетевые интерфейсы | Передача данных между серверами и хранилищем |
| Расширяемость | Добавление ёмкости и производительности |
Если организация рассматривает возможность схд купить, необходимо оценивать не только заявленную ёмкость, но и дисковую производительность, резервирование компонентов, поддерживаемые протоколы и совместимость с платформой виртуализации. Для кластерной инфраструктуры особенно важно исключить необоснованные единые точки отказа.
Почему резервное копирование необходимо в любом случае
Ни кластер высокой доступности, ни зеркалирование дисков не заменяют резервные копии.
Кластер может продолжить работу после аппаратной неисправности, но не обязательно защитит от ошибочного удаления данных, повреждения информации или вредоносного шифрования.
Поэтому необходимо предусмотреть независимые резервные копии, их защиту и регулярные проверки восстановления.
Какая сетевая инфраструктура необходима
При переходе от одного сервера к двум увеличивается значение сетевой архитектуры.
Между вычислительными узлами и системами хранения может передаваться значительный объём данных, особенно при миграции виртуальных машин, репликации и резервном копировании.
Какие виды трафика необходимо учитывать
- Пользовательские подключения к виртуальным машинам.
- Управление гипервизорами и кластером.
- Миграция виртуальных машин между серверами.
- Доступ к общему хранилищу.
- Репликация данных между узлами.
- Резервное копирование и восстановление.
Разные типы трафика могут предъявлять различные требования к пропускной способности, задержкам и отказоустойчивости.
Когда достаточно Gigabit Ethernet
Для небольших инфраструктур с умеренной нагрузкой отдельные гигабитные подключения могут оставаться достаточными.
Однако решение необходимо подтверждать измерениями и требованиями выбранной платформы.
Когда требуется 10 GbE
Высокоскоростные сетевые интерфейсы особенно полезны при интенсивной миграции виртуальных машин, работе с централизованным хранением и передаче больших объёмов данных.
Но сама по себе скорость 10 Гбит/с не гарантирует высокой производительности СХД, если ограничение возникает на стороне накопителей или обработки запросов.
Резервирование сетевых соединений
Для ответственных кластеров необходимо рассматривать не только скорость портов, но и возможность сохранения связи при отказе сетевого адаптера, кабеля или коммутатора.
В зависимости от платформы могут использоваться независимые интерфейсы, несколько сетевых маршрутов, резервные коммутаторы и другие поддерживаемые механизмы.
При подборе активного оборудования сетевой коммутатор необходимо оценивать по скорости и количеству портов, возможностям управления, поддержке необходимых сетевых функций и требованиям к отказоустойчивости. Для серверной инфраструктуры важна также совместимость всей схемы подключения с выбранным гипервизором и хранилищем.
Как лицензирование влияет на стоимость
Сравнение одного мощного сервера и двух небольших устройств невозможно выполнить корректно без учёта программных лицензий.
В некоторых случаях лицензирование составляет значительную часть стоимости виртуализированной инфраструктуры.
Лицензии на гипервизор
Модель лицензирования зависит от используемой платформы, редакции программного продукта, количества физических процессоров или ядер, срока поддержки и доступных функций.
Некоторые возможности высокой доступности и централизованного управления могут зависеть от редакции продукта или условий подписки.
Поэтому перед закупкой необходимо проверить актуальные условия производителя.
Лицензирование гостевых операционных систем
При использовании Windows Server важно отдельно учитывать права запуска виртуальных экземпляров операционной системы.
Например, модель лицензирования Windows Server 2025 предусматривает лицензирование физических ядер сервера с установленными минимальными требованиями. Для определённых типов подписок и лицензий с активной Software Assurance доступен альтернативный вариант лицензирования по виртуальным машинам.
Права на запуск виртуальных сред различаются между редакциями Standard и Datacenter.
Почему два сервера могут увеличить расходы
При проектировании кластера необходимо проверить лицензирование каждого узла, включая возможность запуска на нём виртуальных машин после аварийного переключения.
Нельзя автоматически считать, что лицензии, приобретённые для одного физического сервера, позволяют без дополнительных условий запускать все его нагрузки на другом.
Что включить в расчёт
- Лицензии гипервизора.
- Права запуска гостевых операционных систем.
- Лицензии серверных приложений и баз данных.
- Функции кластеризации и управления.
- Подписки на техническую поддержку.
- Права аварийного переключения и миграции.
- Расходы на обновления и продление лицензий.
Сравнение совокупной стоимости владения
Первоначальная цена оборудования не отражает всех затрат на эксплуатацию серверной инфраструктуры.
Для экономического сравнения используют совокупную стоимость владения — Total Cost of Ownership, или TCO.
Какие расходы учитывать
| Статья расходов | Один мощный сервер | Два небольших сервера |
|---|---|---|
| Вычислительное оборудование | Один комплект | Два комплекта |
| Системы хранения | Локальное или внешнее хранение | Локальное, общее или распределённое хранение |
| Программные лицензии | По выбранной модели лицензирования | С учётом обоих узлов и прав аварийного запуска |
| Сетевая инфраструктура | Обычно проще | Может требовать дополнительных подключений и резервирования |
| Электропитание и охлаждение | Зависит от конфигурации | Зависит от суммарного потребления двух узлов |
| Администрирование | Меньше компонентов | Дополнительные механизмы и процедуры |
| Простой при неисправности | Может затронуть всю нагрузку | Может быть сокращён при правильно реализованной отказоустойчивости |
Формула оценки TCO
Упрощённый расчёт можно представить следующим образом:
TCO = оборудование + лицензии + внедрение + эксплуатация + поддержка + ожидаемые затраты на простои.
Для объективного сравнения необходимо использовать одинаковый расчётный период, например три или пять лет.
Почему нельзя сравнивать только цену процессоров и памяти
Предположим, два небольших сервера стоят немного дороже одного мощного.
Но для создания полноценного кластера могут дополнительно понадобиться внешнее хранилище, резервные сетевые подключения и программные функции высокой доступности.
В итоге разница в стоимости проекта окажется значительно больше разницы в цене физических серверов.
В другой ситуации организация уже располагает подходящей СХД и лицензиями, поэтому добавление второго хоста может оказаться относительно недорогим способом повысить доступность.
Как оценить стоимость простоя
Для критичных приложений полезно учитывать финансовые последствия недоступности.
Ожидаемые потери = продолжительность простоя × оценочная стоимость часа недоступности.
Для сравнения архитектур необходимо учитывать вероятность и последствия разных сценариев отказа. Полученное значение является оценкой, а не гарантированным финансовым результатом.
Как предусмотреть дальнейший рост
Серверную инфраструктуру обычно создают не на один год. Поэтому важно оценить, насколько выбранная архитектура соответствует будущим потребностям.
Вертикальное масштабирование
Вертикальное масштабирование предполагает увеличение ресурсов существующего сервера.
Например, можно добавить оперативную память, установить поддерживаемые накопители или заменить процессоры при наличии такой возможности.
Предел расширения определяется конструкцией платформы и совместимостью компонентов.
Горизонтальное масштабирование
Горизонтальное масштабирование предусматривает добавление новых вычислительных узлов.
Виртуализированная инфраструктура может распределять нагрузку между несколькими серверами, если это поддерживают выбранные программные решения.
Но добавление узла не обязательно линейно увеличивает производительность приложений. Необходимо учитывать особенности их архитектуры, общую систему хранения и сетевые ограничения.
Когда лучше покупать оборудование с запасом
Дополнительные ресурсы оправданы, если организация имеет конкретный прогноз роста.
Например, планирует запуск новых виртуальных машин, расширение базы данных или внедрение ресурсоёмких корпоративных приложений.
При неопределённых планах чрезмерный запас может привести к длительному простаиванию дорогостоящих компонентов.
Почему важна возможность установки третьего узла
При развитии двухузлового кластера добавление третьего сервера в некоторых архитектурах упрощает распределение нагрузки и повышает гибкость обслуживания.
Но это зависит от поддерживаемой конфигурации кластера, модели лицензирования, возможностей хранения и схемы кворума.
Практические сценарии выбора
Сценарий 1. Небольшая компания с шестью виртуальными машинами
Организация использует файловый сервер, контроллер домена, бухгалтерское приложение и несколько внутренних сервисов.
Нагрузка умеренная, а кратковременный простой для обслуживания допустим.
Возможное решение: один производительный сервер с достаточным резервом, надёжным хранением и независимыми резервными копиями.
При этом необходимо заранее определить процедуру восстановления после полного отказа оборудования.
Сценарий 2. Компания с критичной корпоративной системой
Основное приложение должно оставаться доступным в течение рабочего дня. Остановка сервера приводит к существенным операционным потерям.
Возможное решение: два сервера с правильно спроектированной кластерной инфраструктурой, достаточным резервом ресурсов и подходящей архитектурой хранения.
Необходимо определить допустимое время восстановления и проверить фактическое поведение системы при отказе узла.
Сценарий 3. Виртуализация ресурсоёмкой базы данных
Основная нагрузка сосредоточена в одной крупной виртуальной машине, которая требует большого объёма оперативной памяти и высокой производительности процессора.
Возможное решение: один мощный сервер может оказаться эффективнее двух небольших, если ни один из них отдельно не способен обслуживать приложение.
Для высокой доступности потребуется отдельная архитектура, соответствующая требованиям этой нагрузки.
Сценарий 4. Организация уже использует внешнюю СХД
В компании имеется система хранения, которая поддерживает необходимую схему подключения нескольких вычислительных узлов.
Возможное решение: добавление второго сервера может расширить возможности обслуживания и резервирования при относительно меньших дополнительных затратах.
Но необходимо проверить отказоустойчивость самой СХД и сетевых соединений.
Сценарий 5. Офис планирует удвоить количество виртуальных машин
Сегодня инфраструктура обслуживает восемь виртуальных машин, а в перспективе организация планирует увеличить их число до шестнадцати.
Возможное решение: сравнить стоимость вертикального расширения одного сервера с поэтапным добавлением узлов.
Выбор зависит от прогнозируемой одновременной нагрузки, требований к доступности и архитектуры хранения.
Пошаговый алгоритм принятия решения
Шаг 1. Составить перечень виртуальных машин
Укажите назначение, операционные системы и критичность каждого сервиса.
Шаг 2. Измерить текущую нагрузку
Определите загрузку процессоров, потребление памяти, дисковые операции и сетевой трафик.
Шаг 3. Рассчитать необходимые ресурсы
Определите требуемые характеристики серверов для нормальной работы с учётом прогнозируемого роста.
Шаг 4. Установить требования к доступности
Зафиксируйте допустимое время восстановления — RTO — и допустимую потерю данных — RPO — для важных сервисов.
Шаг 5. Рассмотреть сценарии отказов
Проверьте последствия отказа хоста, дисков, сети, электропитания и системы хранения.
Шаг 6. Выбрать архитектуру хранения
Сравните локальные накопители, совместимую общую СХД и поддерживаемые распределённые решения.
Шаг 7. Рассчитать резерв при отказе
Если планируется кластер, проверьте, сможет ли оставшееся оборудование обслуживать критичную нагрузку при отказе одного узла.
Шаг 8. Проверить программные лицензии
Уточните условия лицензирования гипервизора, гостевых систем и приложений для всех предусмотренных режимов работы.
Шаг 9. Сравнить стоимость владения
Включите оборудование, хранение, сеть, лицензии, электропитание, сопровождение и последствия возможных простоев.
Шаг 10. Проверить архитектуру перед вводом
По возможности проведите нагрузочное тестирование, проверку резервного копирования и испытания предусмотренных сценариев отказа.
Типичные ошибки проектирования
Сравнение только суммарной памяти
Два сервера по 128 ГБ не эквивалентны одному серверу на 256 ГБ для задач, требующих большой памяти в пределах одного хоста.
Предположение, что два сервера автоматически обеспечивают HA
Без соответствующей программной платформы, доступности данных и настройки восстановления второй сервер может не принять нагрузку после отказа первого.
Отсутствие резерва вычислительных ресурсов
Если оба узла работают близко к пределу возможностей, после отказа одного оставшийся сервер может оказаться неспособным разместить все критичные виртуальные машины.
Игнорирование производительности хранения
Дополнительные серверы не устраняют ограничения перегруженной дисковой подсистемы.
Недооценка стоимости лицензирования
При сравнении необходимо учитывать права запуска виртуальных машин на каждом физическом узле и действующие условия программных продуктов.
Общая точка отказа в сети
Два сервера могут потерять доступ к данным одновременно, если используют единственный коммутатор или общий незащищённый сетевой путь.
Отсутствие независимых резервных копий
Кластеризация и репликация не заменяют возможность восстановления данных после логической ошибки, удаления или повреждения.
Закупка избыточного оборудования без расчётов
Большое количество процессорных ядер и памяти не гарантирует экономической эффективности, если реальные приложения не используют эти ресурсы.
Итог
Один мощный сервер и два небольших устройства могут быть эффективными решениями для виртуализации, но отвечают разным эксплуатационным требованиям.
Односерверная архитектура часто обеспечивает более простое управление и меньшую первоначальную сложность. Она подходит для компаний, которые допускают определённый простой и могут восстановить сервисы из резервных копий или на резервной платформе.
Два сервера позволяют распределять нагрузку и создавать основу для высокой доступности. Однако полноценная отказоустойчивость требует дополнительного проектирования, подходящей конфигурации хранения, сети, программных механизмов и резерва ресурсов.
Перед закупкой необходимо проверить:
- Количество и ресурсоёмкость виртуальных машин.
- Потребность в процессорных ресурсах и оперативной памяти.
- Производительность дисковой подсистемы.
- Требования к доступности приложений.
- Допустимое время восстановления и потерю данных.
- Возможность работы после отказа одного сервера.
- Архитектуру хранения и сетевого подключения.
- Необходимые лицензии.
- Совокупную стоимость владения.
- Перспективы дальнейшего расширения.
Главный принцип выбора — оценивать не количество физических серверов, а способность всей инфраструктуры обеспечивать необходимую производительность, доступность и возможность развития при обоснованных затратах.
Грамотный расчёт помогает избежать как недостаточной производительности и единой точки отказа, так и покупки сложной дорогостоящей архитектуры, возможности которой организация не будет использовать.
Часто задаваемые вопросы
Что лучше для виртуализации: один мощный сервер или два небольших?
Один мощный сервер часто выгоднее для небольшой инфраструктуры с допустимым временем простоя. Два сервера предпочтительнее при необходимости распределения нагрузки и построения отказоустойчивого кластера. Выбор зависит от ресурсоёмкости виртуальных машин, требований к доступности, архитектуры хранения и стоимости лицензирования.
Достаточно ли двух серверов для отказоустойчивости?
Нет. Для автоматического восстановления виртуальных машин необходимы соответствующая платформа виртуализации, доступность данных на оставшемся узле, корректная настройка кластерных механизмов и достаточный резерв ресурсов. В двухузловых кластерах также важно правильно организовать кворум.
Нужна ли отдельная СХД для двух серверов?
Не всегда. Некоторые архитектуры используют общую внешнюю систему хранения, другие — поддерживаемую репликацию или программно-определяемое распределённое хранение. Выбор зависит от гипервизора, требований к доступности и возможностей оборудования. Необходимо учитывать поддерживаемые конфигурации и поведение системы при отказе.
Какой объём памяти нужен для двухузлового кластера?
Объём памяти определяется потребностями виртуальных машин, гипервизора и запланированным резервом. Если требуется сохранить работу всех критичных виртуальных машин после отказа одного узла, оставшийся сервер должен иметь достаточные ресурсы для их размещения в предусмотренной конфигурации.
Можно ли перенести виртуальные машины между двумя серверами без остановки?
Да, если выбранная платформа виртуализации поддерживает живую миграцию и выполнены её требования к процессорам, сети, хранению и конфигурации виртуальных машин. Наличие двух физических серверов само по себе не гарантирует возможность переноса без остановки.
Нужен ли 10 GbE для серверной виртуализации?
Не обязательно. Для небольших нагрузок могут быть достаточны гигабитные подключения. 10 GbE особенно полезен при интенсивной миграции виртуальных машин, использовании сетевых хранилищ и передаче больших объёмов данных. Скорость следует выбирать по требованиям платформы и измеренной нагрузке.
Заменяет ли кластер резервное копирование?
Нет. Кластер высокой доступности предназначен для сохранения или восстановления работы сервисов при определённых неисправностях. Резервное копирование необходимо для восстановления данных после удаления, повреждения, программных ошибок и других инцидентов. Оба механизма решают разные задачи.
Что дешевле в эксплуатации: один сервер или два?
Один сервер часто требует меньше компонентов и проще в обслуживании. Два сервера могут увеличивать затраты на оборудование, хранение, сеть и лицензии, но правильно реализованная отказоустойчивость способна уменьшить последствия простоев. Для сравнения необходимо рассчитывать совокупную стоимость владения с учётом требований организации.