
Как обеспечить корректную работу телекоммуникационного оборудования при отключениях сети с помощью ИБП и мониторинга


Почему даже короткие отключения ломают связь и какие сбои бизнес замечает первым
Связь в компании редко падает красиво и предсказуемо. Чаще сеть деградирует: часть сервисов отвечает медленно, телефония начинает рваться, VPN то поднимается, то сбрасывает сессии, кассы и терминалы теряют связь с учётной системой, а сотрудники пишут в чат, что интернет опять умер. Причина часто лежит не в провайдере и не в настройках, а в питании узлов связи и в отсутствии контроля за тем, как инфраструктура переживает провалы напряжения.
Что именно считается отказом для связи: потеря питания, потеря линка, деградация качества
Для бизнеса отказ выглядит как недоступность услуги. Для инженера отказ делится на несколько уровней:
- Потеря питания — оборудование выключается или перезапускается, таблицы коммутации и маршрутизации сбрасываются, сессии разрываются.
- Потеря линка — питание может оставаться, но физический уровень рушится из-за проблем на линии, зависания порта или перезагрузки промежуточного узла.
- Деградация качества — линк поднят, но растёт задержка, появляются потери пакетов, джиттер выходит за рамки, и голос с видео начинают разваливаться раньше, чем упадут веб-сервисы.
Надёжная схема резервного питания должна защищать от всех трёх уровней. Если защитить только серверы и оставить узлы доступа без питания, бизнес всё равно потеряет сервисы, потому что пользователи не дойдут до серверов по сети.
Какие узлы падают первыми и почему это важно
Первые жертвы отключений обычно сидят ближе к пользователю, а не в серверной. При просадках напряжения и кратковременных провалах быстрее всего страдают блоки питания в компактных коммутаторах и точках доступа, особенно если шкафы стоят без ИБП и без нормальной вентиляции. Далее по цепочке падают агрегирующие коммутаторы, маршрутизаторы, VoIP-шлюзы, контроллеры Wi-Fi и любые устройства, которые не любят грязное питание.
Если инфраструктура включает телекоммуникационное оборудование, приоритет питания нужно строить вокруг связности: без доступа к ядру сети и без работающего уровня доступа не выживет ни телефония, ни VPN, ни контроль доступа, ни видеонаблюдение, даже если серверы продолжают работать на резерве.
Чем опасны микропровалы и скачки напряжения даже без полного отключения
Микропровалы опаснее тем, что они создают нестабильное поведение без явного факта аварии. Оборудование может не выключиться полностью, но блок питания уходит в защиту, порты начинают флапать, устройства перезагружаются выборочно, а журналы фиксируют странные события. Скачки напряжения ускоряют деградацию аккумуляторов, провоцируют перегрев и приводят к скрытым отказам через месяцы, когда кажется, что авария давно позади.
Какие последствия критичнее всего и как они проявляются
Бизнес быстрее всего замечает то, что связано с коммуникацией и деньгами:
- Телефония и контакт-центр — обрывы разговоров, невозможность дозвониться, потеря записи и статистики.
- Кассы и эквайринг — транзакции не проходят, очередь растёт, персонал делает ручные операции.
- VPN и филиалы — разрывы туннелей, повторные аутентификации, потеря удалённых рабочих мест.
- Системы безопасности — недоступность камер, потеря событий, невозможность открыть дверь по сети при централизованной логике.
Быстрые ответы по теме
Нужно ли питать от ИБП только серверную или также узлы доступа и связь на этажах
Сеть удерживает сервисы в живом состоянии так же, как серверы. Если компания питает только серверную, но оставляет без резерва шкафы доступа и узлы связи на этажах, пользователи всё равно потеряют доступ к системам. Практика чаще требует распределённого подхода: минимум питания для узлов доступа и для критичных точек связи плюс резерв в серверной для ядра и сервисов.
Достаточно ли автономии на 5–10 минут или нужно закладывать больше
Автономия 5–10 минут подходит, когда компания хочет пережить кратковременные провалы и корректно завершить работу сервисов. Для объектов с генератором автономия часто ориентируется на время запуска и стабилизации, которое может занимать минуты. Если персонал физически устраняет аварии или провайдер восстанавливает питание дольше, автономию имеет смысл увеличивать, но только после расчёта нагрузки и сценариев деградации.
Карта нагрузки и приоритетов: что питать в первую очередь, а что можно отключать
Критичные группы нагрузок и почему они важнее всего
Критичность определяется зависимостями. Если связь падает, серверы превращаются в остров. Поэтому приоритет обычно строится так:
- Ядро сети — маршрутизация, коммутация между сегментами, точки выхода к провайдеру и к VPN.
- Агрегация и доступ — коммутаторы в шкафах, точки доступа, контроллеры, питание PoE для критичных устройств.
- Сервисы связи — IP-АТС, SBC/шлюзы, сервисы аутентификации и DNS/NTP, если без них рушатся сессии.
- Системы безопасности — ключевые камеры, контроллеры доступа, узлы хранения событий, если бизнес требует непрерывности.
Даже в небольшом офисе узлы доступа часто важнее, чем часть вычислительных мощностей. Инженер может оставить один сервер на резерве и отключить второстепенные сервисы, но он не сможет компенсировать отсутствие коммутатора на этаже.
Некритичные нагрузки: что можно отключать при аварии
Некритичные нагрузки зависят от бизнеса, но принцип остаётся одинаковым: отключать всё, что не удерживает связность и безопасность. Часто к некритичным относят лабораторные стенды, часть пользовательских рабочих мест, тестовые системы, дополнительное освещение стойки, второстепенные точки Wi-Fi и вспомогательные сервисы, которые не влияют на восстановление.
Приоритеты по цепочке зависимости
Приоритеты удобно строить через простой вопрос: если этот узел выключится, сколько систем потеряют связь и сколько людей остановят работу. Сетевой коммутатор на доступе может обслуживать десятки рабочих мест и несколько критичных устройств. Один сервер приложения может обслуживать только одну функцию. Поэтому порядок питания часто выглядит непривычно для руководителя, но он логичен для инженера: связь раньше приложений.
Типовые режимы при аварии: нормальный, деградация, аварийное выключение
- Нормальный режим — ИБП поддерживает питание, мониторинг фиксирует параметры и предупреждает о рисках.
- Режим деградации — часть нагрузок отключается, бизнес сохраняет связь и критичные функции, остальное уходит в паузу.
- Аварийное выключение — система корректно завершает работу, чтобы сохранить оборудование и данные, и не допустить глубокого разряда батарей.
Как оценить реальную автономию без иллюзий: методика расчёта и допущения
Базовые параметры для расчёта: активная мощность, коэффициент мощности, пусковые токи
Корректная оценка автономии начинается с измерения реального потребления. Инженер должен понимать активную мощность нагрузки и то, как она меняется в рабочие пики. Для сетевых шкафов потребление часто выглядит стабильным, но PoE-нагрузка и пусковые токи у некоторых блоков питания могут давать кратковременные пики. Эти пики важны, потому что ИБП должен выдержать их без перегруза и перехода в байпас.
Практичный порядок:
- измерить потребление ключевых узлов в штатном режиме
- оценить пиковые сценарии, например максимальная PoE-нагрузка или запуск сервисов после перезагрузки
- заложить запас по мощности, чтобы ИБП не работал на пределе
Почему паспортные значения редко совпадают с реальностью
Паспортная автономия почти всегда предполагает идеальные условия: новая батарея, оптимальная температура, конкретная нагрузка и отсутствие деградации. Реальный объект приносит другое:
- Температура в шкафу ускоряет старение аккумуляторов и снижает доступную ёмкость.
- Старение приводит к тому, что через 12–24 месяца автономия может заметно снизиться, особенно при высокой температуре и частых разрядах.
- Профиль нагрузки меняется со временем: добавляются точки Wi-Fi, камеры, новые узлы доступа.
Типичные диапазоны автономии и как их трактовать безопасно
Без привязки к моделям можно говорить только диапазонами. Для небольшого сетевого шкафа с коммутатором и маршрутизатором часто встречается цель в диапазоне 10–30 минут, чтобы пережить кратковременные отключения и дать время на запуск генератора или корректное переключение. Для серверной автономия может уходить в диапазон 15–60 минут и выше, но финальное значение зависит от суммарной нагрузки и сценария восстановления.
Если точные цифры критичны, расчёт нужно опирать на измерения и на реальную конфигурацию. Любая попытка назначить точную автономию без данных приводит к самообману.
Запас по мощности и запас по времени
Запас по мощности защищает от перегруза и непредсказуемых пиков. Запас по времени защищает от деградации батарей и отклонений условий. Практика обычно требует закладывать время не под текущую идеальную батарею, а под батарею, которая потеряла часть ёмкости через эксплуатацию. Такой подход снижает риск, что через год объект перестанет держать нужную автономию.
Когда выгоднее несколько ИБП по зонам вместо одного крупного
Распределённая схема даёт управляемость и локальную устойчивость. Если компания питает от одного крупного ИБП сразу все шкафы, один отказ может уронить всё. Несколько ИБП по зонам позволяют удержать критичные сегменты даже при проблемах в одной зоне, а также упрощают обслуживание: можно заменить батареи в одном шкафу, не останавливая весь объект.
Архитектуры резервного питания для связи и ИТ: что выбрать под объект
ИБП в серверной плюс локальные ИБП в шкафах доступа
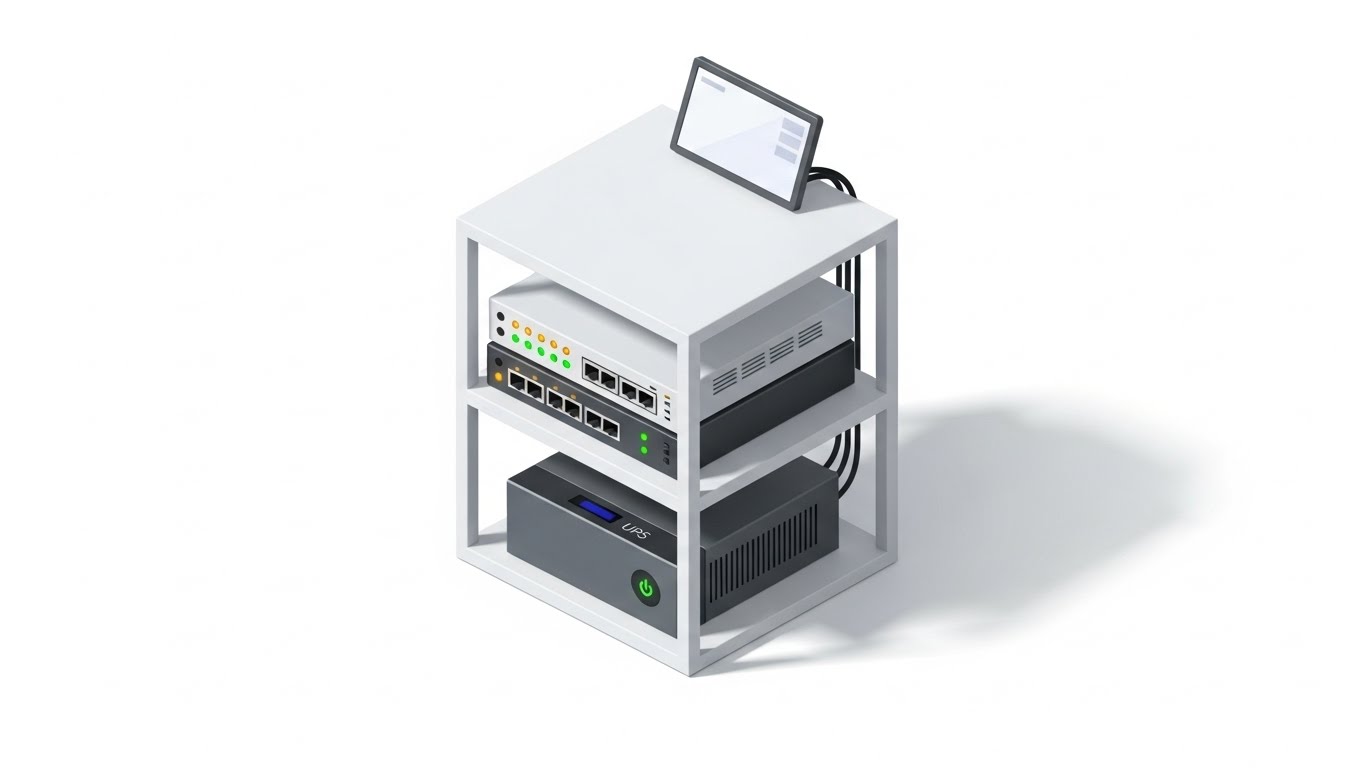
Эта схема часто даёт лучший баланс. Серверная держит ядро сети, пограничные устройства, сервисы связи и критичные серверы. Шкафы доступа на этажах или на складе держат коммутаторы доступа, точки Wi-Fi и критичные PoE-устройства. Такая архитектура минимизирует зависимость филиалов и пользователей от одной точки питания и сокращает время восстановления после аварии.
Централизованное питание стойки и распределение по PDU
Централизация помогает в крупных серверных: легче управлять нагрузкой, контролировать потребление и обслуживать батареи. Но она требует дисциплины кабельного хозяйства и продуманного распределения: один PDU не должен становиться единственным плечом питания для всего. Для критичных узлов стоит предусмотреть разнесение по двум линиям питания, если оборудование поддерживает два блока питания.
Резервирование по схеме N+1 для критичных узлов
N+1 означает, что система выдерживает отказ одного элемента без остановки. Для связи это особенно важно на узлах, где сходятся VLAN, туннели и телефония. Если компания не может позволить простой, резервирование по питанию и по ключевым узлам сети даёт реальную устойчивость, но оно увеличивает сложность и стоимость. Здесь важно честно оценить, какие точки действительно требуют N+1, а где достаточно надёжной базовой схемы.
Байпас и обслуживание без остановки связи
Обслуживание батарей и плановые работы неизбежны. Архитектура должна позволять обслуживать ИБП и заменять аккумуляторы без полного обесточивания узла. Для этого используют байпас на уровне стойки или на уровне ИБП, а также заранее планируют окно работ и порядок переключений. Без такой подготовки обслуживание превращается в рискованный эксперимент.
Сценарии с генератором и согласование времени автономии с временем запуска
Если на объекте есть генератор, цель автономии часто сводится к перекрытию времени запуска и стабилизации. Но инженер должен учитывать реальную картину: генератор может не стартовать, автоматика может отработать с задержкой, а нагрузка в момент переключения может измениться. Поэтому автономию стоит выбирать с запасом, который покрывает типовые отклонения и даёт время на ручное вмешательство.
При подборе решения под конкретный объект полезно опираться на понятные сценарии и на доступность сервиса и расходников, а не только на паспортные цифры. Если закупка идёт по локальному запросу ИБП в Минске, инженер должен дополнительно проверить совместимость по форме-фактору, условиям установки, режимам мониторинга и требованиям по обслуживанию батарей, потому что эти параметры влияют на итоговую устойчивость сильнее, чем формальная мощность.
Мониторинг и управление: что контролировать, чтобы не узнавать о проблеме от пользователей
Какие метрики важны: заряд, нагрузка, температура, события по входу и выходу
ИБП без мониторинга превращается в чёрный ящик. Мониторинг должен отвечать на простые вопросы: сколько осталось времени, какая нагрузка, в каком состоянии батареи, что происходит с входным напряжением и как система переживает события питания. Для сетевой инфраструктуры важны не только аварийные события, но и медленные изменения: рост нагрузки, повышение температуры в шкафу, деградация батарей.
Минимально полезный набор метрик:
- состояние питания: работа от сети или от батареи, частота переключений
- уровень нагрузки и её динамика
- оценка оставшегося времени, если устройство её предоставляет
- температура в зоне батарей и в шкафу
- события: перегруз, переход в байпас, глубокий разряд, тест батарей
Как строить оповещения: пороги предупреждения и аварии
Оповещения должны помогать, а не шуметь. Для этого стоит разделить уровни:
- Предупреждение — нагрузка растёт, температура повышается, батарея деградирует, тест показывает ухудшение.
- Авария — работа от батареи, перегруз, переход в байпас, критическое падение заряда.
- Инцидент — повторяющиеся события питания, которые совпадают с сетевыми сбоями.
Хорошие пороги зависят от объекта. Если команда не может приехать быстро, пороги должны давать запас времени, а не фиксировать факт поздно.
Корреляция событий питания и сетевых инцидентов
Питание и сеть нужно связывать в одном расследовании. Если коммутатор доступа начал флапать порты, а ИБП в этот момент зафиксировал переход на батарею или скачок входного напряжения, инженер получает первопричину. Без корреляции команда тратит часы на поиск проблемы в прошивках, VLAN и кабеле, хотя реальная причина лежит в питании.
Тестирование под нагрузкой: плановые проверки и фиксация результатов
Проверка резерва должна имитировать реальность. Плановый тест должен включать работу под типичной нагрузкой и проверку того, что связь не деградирует. После теста важно фиксировать результат: время автономии, поведение узлов, наличие ошибок портов и скорость восстановления.
Регламент эксплуатации: кто отвечает за тесты и замену батарей
Регламент должен назначить ответственных и периодичность. Батареи деградируют, а объект меняется. Если никто не отвечает за тесты и замену, система резерва превращается в украшение стойки. Регламент должен описывать: кто проводит тест, кто утверждает результат, кто планирует замену батарей и кто обновляет документацию.
Матрица выбора решения: как зафиксировать архитектуру и не потерять контроль
Матрица помогает выбрать архитектуру под сценарий объекта и заранее увидеть риски. Она также помогает руководителю понять, за что компания платит: за автономию, за управляемость, за снижение простоя или за возможность масштабирования.
| Сценарий объекта | Приоритетная нагрузка | Целевое время автономии | Рекомендуемая архитектура | Требования к батареям и условиям | Критичные риски | Что обязательно мониторить |
|---|---|---|---|---|---|---|
| Небольшой офис без генератора | Пограничный узел, ядро, ключевой коммутатор доступа, Wi-Fi контроллер при наличии | Обычно ориентируются на 10–30 минут, но финал задаёт сценарий работы | ИБП для серверной или главного шкафа плюс локальные решения для критичных шкафов | Нормальная температура в шкафу, запас по мощности, план замены батарей | Питание только серверов без узлов доступа, перегрев в шкафу, отсутствие тестов | Переход на батарею, нагрузка, температура, события перегруза |
| Офис с генератором и автозапуском | Ядро сети, пограничный узел, сервисы телефонии и аутентификации | Выбирают с запасом на запуск и стабилизацию генератора | ИБП на критичных узлах плюс продуманная схема байпаса и переключений | Стабильная температура, корректные циклы тестирования, защита от глубокого разряда | Генератор не стартует, переключение даёт провал, ИБП уходит в байпас при перегрузе | События входного питания, частота переключений, перегруз, восстановление после возврата сети |
| Склад с распределёнными шкафами | Шкафы доступа, Wi-Fi, критичные PoE-узлы, связь с серверной | Часто достаточно 10–20 минут на ключевых шкафах, но зависит от процессов | Несколько локальных ИБП по зонам, минимум зависимости от одного узла | Учет температуры, пыли, доступ к обслуживанию, защита от вибраций | Потеря связи в одной зоне останавливает операции, отсутствие мониторинга в удалённых шкафах | Температура в шкафах, состояние батарей, события питания по зонам |
| Магазин или сеть точек с кассами и VoIP | Пограничный узел, кассовая сеть, VoIP, Wi-Fi для служебных устройств | Ориентир выбирают по времени завершения операций и восстановлению канала | Локальный ИБП на узле связи и кассовом сегменте плюс простая схема деградации | Запас по мощности, контроль качества питания, регулярные короткие тесты | Перегруз при пиках, отсутствие плановой замены батарей, шумные оповещения без действий | Заряд, нагрузка, события питания, корректность восстановления связи |
| Серверная с критичной связью и VPN для филиалов | Ядро сети, пограничные устройства, VPN, DNS/NTP, телефония при наличии | Часто выбирают 20–60 минут и выше, но расчёт требует измерений | Централизованный ИБП с байпасом, разнесение питания по линиям, резервирование на критичных узлах | Строгий контроль температуры, план замены батарей, тестирование под нагрузкой | Ошибки в приоритетах питания, отсутствие байпаса, деградация батарей незаметно для команды | Нагрузка, температура, тест батарей, переходы в байпас, корреляция с сетевыми алертами |
Частые ошибки при организации бесперебойного питания связи и как их избежать
- Питают только серверы и забывают про узлы доступа. Пользователи теряют сеть и не получают доступ к сервисам, даже если серверы живут на резерве.
- Не учитывают пусковые токи и реальный профиль PoE-нагрузки. ИБП уходит в перегруз или в байпас в момент, когда объект больше всего нуждается в резерве.
- Не закладывают деградацию батарей. Через год автономия падает, а команда узнаёт об этом при первом реальном отключении.
- Игнорируют температуру в шкафах. Батареи стареют быстрее, электроника работает на грани, растёт вероятность отказа.
- Не проводят тесты под нагрузкой. Паспортные ожидания расходятся с реальностью, а риск простоя растёт.
- Настраивают оповещения без логики. Команда получает поток уведомлений, привыкает к шуму и пропускает критические события.
Проверка перед внедрением и дальнейшей эксплуатацией: чек-лист действий
- Составить перечень узлов, которые удерживают связь: пограничные устройства, ядро, агрегация, критичный доступ, сервисы связи.
- Измерить реальное потребление в штатном режиме и оценить пики, включая PoE-нагрузку.
- Определить целевой сценарий: пережить провал, дождаться генератора, корректно завершить работу, удержать связь для филиалов.
- Выбрать архитектуру: централизованная в серверной, распределённая по шкафам, комбинированная.
- Проверить условия установки: температура, вентиляция, доступ к обслуживанию, защита от пыли и случайного отключения.
- Заложить запас по мощности и времени с учётом деградации батарей и роста нагрузки.
- Настроить мониторинг: события питания, нагрузка, температура, тесты батарей, переходы в байпас.
- Настроить оповещения с разделением предупреждений и аварий, определить ответственных за реакцию.
- Провести тест под нагрузкой и зафиксировать: автономию, поведение сети, время восстановления, наличие ошибок портов и сервисов.
- Ввести регламент обслуживания: периодичность тестов, правила замены батарей, порядок документирования изменений.
- Обновлять карту нагрузок после изменений сети, чтобы ИБП не стал неожиданной точкой перегруза.
Итоговая логика решения: как прийти к стабильной связи при отключениях
Связь выступает базовым слоем непрерывности: без неё бизнес теряет доступ к сервисам быстрее, чем серверы теряют питание. Поэтому резервирование нужно начинать с узлов сети и узлов доступа, а затем добавлять вычислительные ресурсы по приоритету. Реалистичный расчёт автономии требует измерений, запаса по мощности и учёта старения батарей, иначе ожидания разойдутся с фактом. Мониторинг превращает ИБП в управляемый элемент инфраструктуры: он позволяет увидеть деградацию заранее и связать сетевые инциденты с событиями питания. Регламент тестов и обслуживания удерживает систему работоспособной годами, а не только в день монтажа. В результате компания получает предсказуемую деградацию при аварии и контролируемое восстановление вместо хаотичного простоя.